Уровень 6 (занятие) · лекция · 10 октября, 11:10
Риски и оценка нагрузки: критический путь и деградация
Как найти и ранжировать риски проекта, сформулировать самое рискованное допущение и проверить его, прикинуть нагрузку на салфетке, найти критический путь системы и составить план деградации.
Курс «Проектирование веб-приложений» · 2026/27
Риски и оценка нагрузки
Что может сломать проект, какое допущение проверить первым, сколько ресурсов нужно системе и что отключать, когда их не хватает
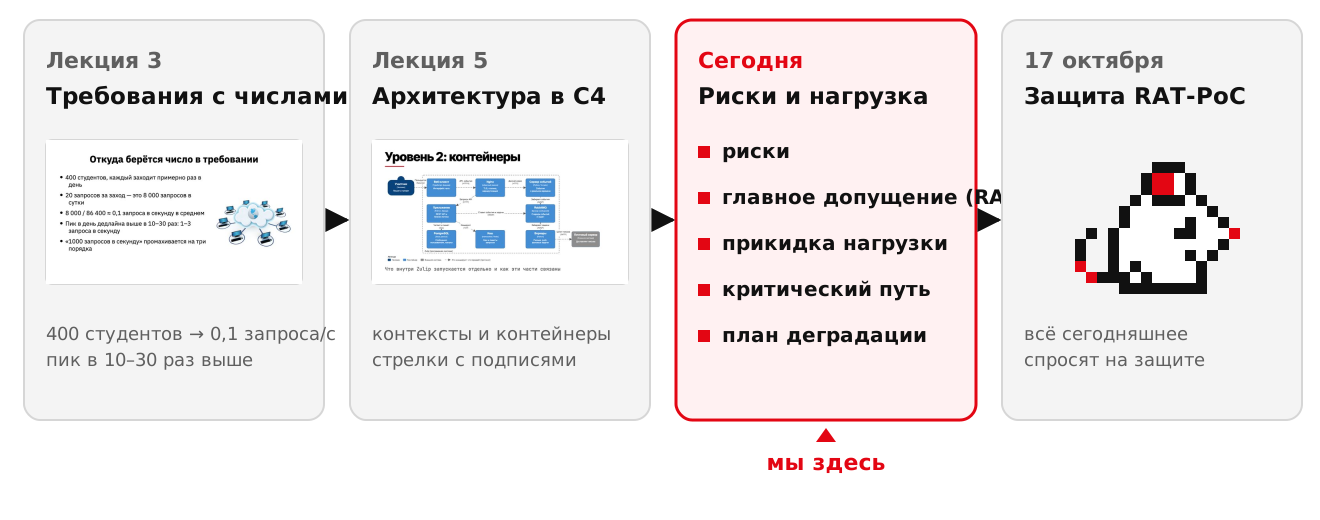
Где мы
Что спросят на защите RAT-PoC
- Риски по группам: технические, архитектурные, бизнес
- Для каждого риска решение на методе или технологии, а не на надежде
- Самое рискованное допущение и как его проверили
- Критический путь системы
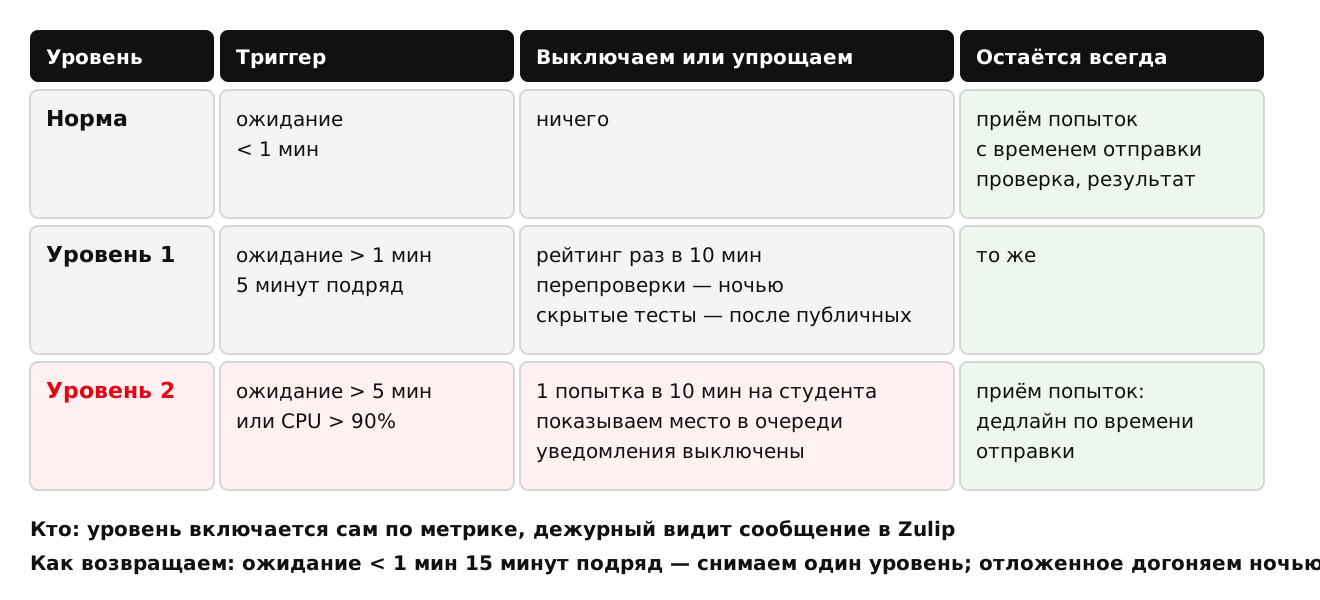
- План деградации под нагрузкой: триггер, что выключаем, как возвращаем
Всё это есть в рубрике этапа на странице босса RAT-PoC
Сквозной пример: автопроверка заданий
- Студент загружает решение, система прогоняет тесты и показывает результат
- 400 студентов, задание раз в неделю, дедлайн в субботу в 23:59
- В среднем три попытки на задание
- Требование: результат не позже чем через минуту после отправки
Похожий проект был у команды прошлого года
Риски проекта
Риск — это ещё не случившееся
Риск — событие, которое может произойти и помешать проекту достичь цели
- Задача: «сделать очередь проверок» — её надо просто сделать
- Проблема: «сервер упал вчера» — уже случилось, надо чинить
- Риск: «если в последние 10 минут придёт 150 попыток, очередь не успеет»
Если [условие], то [последствие для пользователя или проекта]
Три группы рисков
Технические
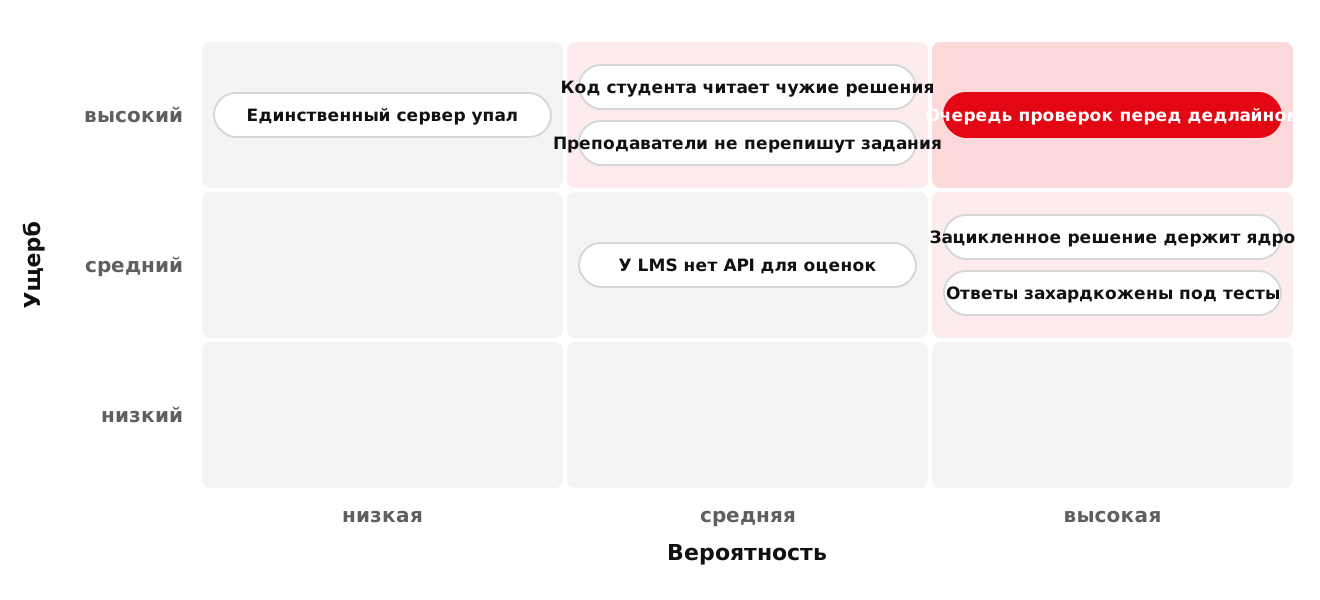
- Перед дедлайном очередь растёт быстрее, чем разбирается
- Зацикленное решение держит ядро
- Код студента читает чужие решения
Архитектурные
- Вся проверка на одном сервере
- У LMS нет API для выгрузки оценок
- Формат тестов привязан к одному языку
Бизнес
- Преподаватели не перепишут задания под тесты
- Студенты подгоняют ответы под тесты
- Курс закончится, поддерживать некому
Где искать риски
- Пройти по user stories: что должно случиться, чтобы история не сработала?
- Пройти по контейнерам C4: что будет, если этот блок упадёт или замедлится?
- Внешние зависимости: чужие API, LMS, Telegram, модели, платёжки
- Данные: что нельзя потерять и что нельзя показать чужим
- Команда: чего мы ещё ни разу не делали
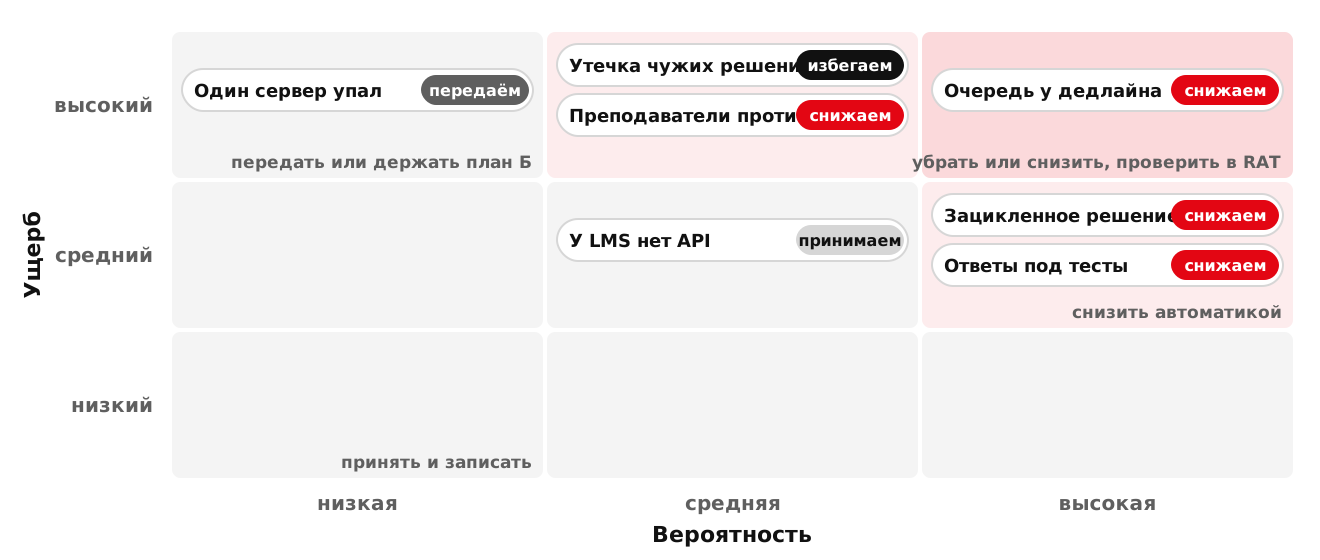
Матрица рисков
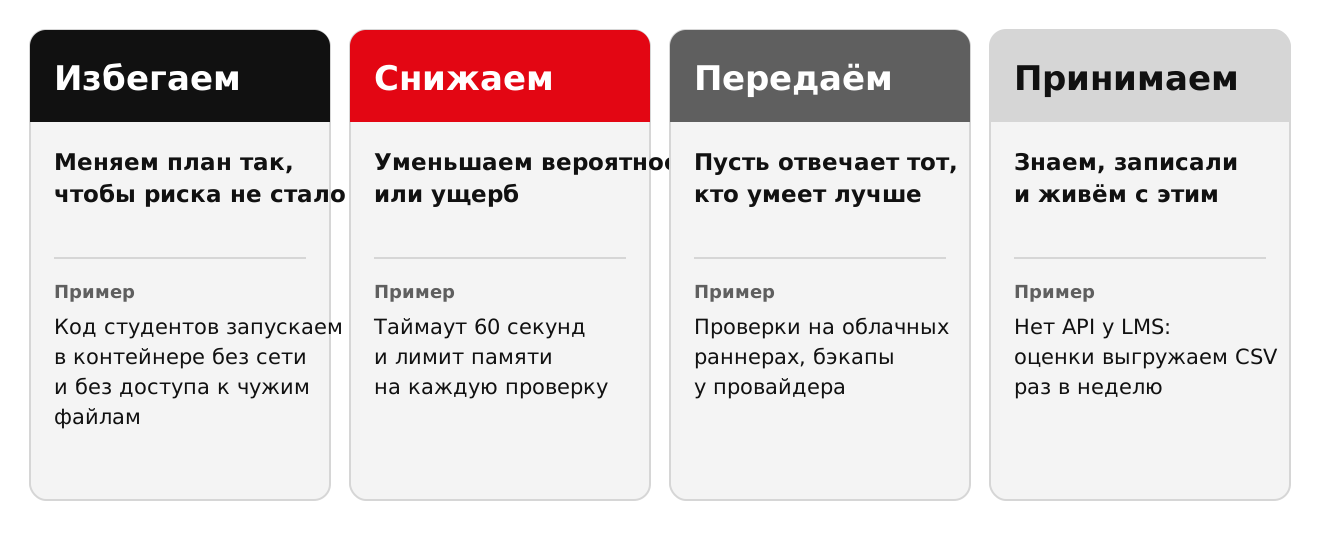
Что делать с риском
Матрица: чем закрываем риски
Как не надо и как надо
Как не надо
Как надо
«Риск: не успеем»
«Если интеграция с API вуза займёт больше двух недель, к прототипу не будет данных»
«Рост пользователей перегрузит API → переходим на микросервисы»
«15 проверок в минуту загрузят CPU → очередь и лимит параллельных проверок»
«100 одновременных пользователей», взятые со слайда
Число из своей аудитории и своего пика, с источником
«Критический путь: диск»
Цепочка главного сценария и ресурс на каждом шаге
Двадцать рисков без порядка
Матрица и первая тройка с решениями
Самое рискованное допущение
RAT: проверить самое опасное первым
RAT — Riskiest Assumption Test, проверка допущения, из-за которого проект развалится, если оно неверно
- Допущение — то, во что команда верит, но ещё не проверила
- Выбираем из правого верхнего угла матрицы
- Проверяем самым дешёвым способом, который даёт ответ
- Заранее пишем, какой результат считаем успехом
Мы считаем, что… Проверим так… Подтвердилось, если…
RAT автопроверки
- Мы считаем, что 8 ядер справятся с пиком: 15 попыток в минуту по 20 секунд
- Проверим так: прогоним 150 настоящих решений за 10 минут через прототип очереди
- Подтвердилось, если 95% результатов приходят быстрее минуты и ни одна попытка не потерялась
- Не подтвердилось — меняем план до того, как написан остальной продукт
PoC, прототип, MVP
PoC
- Отвечает: это вообще возможно?
- Проверяет одно допущение
- Пользователь его не видит
- Можно выбросить
Прототип
- Отвечает: так ли это будет работать?
- Показывает основные сценарии
- Пользователь может потрогать
- Часть кода выживает
MVP
- Отвечает: нужно ли это людям?
- Минимум, которым реально пользуются
- Работает на настоящих пользователях
- Это уже продукт
Как оценить ресурсы
Оценка нагрузки на систему
- Одновременность: сколько пользователей активны в одно и то же время
- Поток запросов: сколько запросов в секунду приходит на сервер
- Объём данных: записи в базе, файлы, трафик по сети
Из этих трёх чисел выводится всё остальное
Запросы в секунду
RPS — Requests Per Second, сколько запросов система получает и обрабатывает за секунду
- Главная единица для всех остальных прикидок
- Главный вопрос — какой промежуток взять: неделю, час или последние 10 минут перед дедлайном
RPS = запросов за промежуток / длина промежутка в секундах
Пример расчёта RPS
- 100 пользователей за визит длиной 5 минут, то есть 300 секунд
- По 5 запросов за визит — 500 запросов
- 500 / 300 ≈ 1,7 запроса в секунду
Откуда взялись 100 пользователей? Ниоткуда. Число должно браться из вашей аудитории
Пик важнее среднего
- 1 200 проверок в неделю — в среднем 0,002 в секунду
- Половина приходится на последние 2 часа: 600 за 7 200 секунд — 0,08 в секунду
- В последние 10 минут ещё втрое больше: 0,25 в секунду, 15 в минуту
- Пик выше среднего за неделю больше чем в 100 раз
Систему считают на пик, а не на среднее: в среднем она простаивает
Откуда взять числа для своего проекта
- Аудитория: сколько людей реально придёт в первый год, а не «все студенты России»
- Ритм: когда приходят — расписание, дедлайн, рассылка, вечер пятницы
- Действия за визит: пройти свой главный сценарий и посчитать запросы во вкладке Network
- Пиковый коэффициент: из природы продукта, а не «умножим на два»
Всё остальное считаем от RPS
- Процессор: время обработки на ядре × RPS — сколько ядер занято
- Память: память на запрос × сколько запросов идёт одновременно
- Диск в день: запросов в день × объём записи на запрос
- Сеть: размер запроса или ответа × RPS
Формулы простые, ошибаются в единицах: КБ и МБ, миллисекунды и секунды
Сколько запросов обрабатывается одновременно
Закон Литтла
- Автопроверка: 0,25 попытки в секунду × 20 секунд = 5 проверок одновременно
- 5 проверок — 5 занятых ядер из 8, запас в 1,6 раза
- Тесты стали идти 60 секунд — нужно 15 ядер, очередь растёт без предела
- Так же считаются соединения с БД, воркеры и память
Одновременно в системе = поток в секунду × время на один запрос
Ресурсы автопроверки на пике
| Ресурс | Нужно на пике | Есть | Запас |
|---|---|---|---|
| Процессор проверки | 5 ядер0,25 проверки/с × 20 с × 1 ядро | 8 ядер | в 1,6 раза |
| Процессор веба | 0,4 ядра20 RPS × 20 мс | те же 8 ядер | в 20 раз |
| Память | 2,5 ГБ5 контейнеров × 512 МБ | 16 ГБ | в 6 раз |
| Диск | 4 ГБ за семестр1 200 архивов × 200 КБ в неделю | 100 ГБ | в 25 раз |
| Сеть | 50 КБ/с0,25 загрузки/с × 200 КБ | 100 Мбит/с ≈ 12 МБ/с | в 240 раз |
Упирается процессор проверки: 5 ядер из 8. Остальное с запасом от 6 раз до сотен
По среднему всё хорошо, на пике нет
| Нагрузка | Проверок/с | Ядер, проверка 20 с | Ядер, проверка 60 с |
|---|---|---|---|
| Среднее за неделю | 0,0021 200 / 604 800 | 0,04 ядра0,002 × 20 с | 0,12 ядра0,002 × 60 с |
| Последние 2 часа | 0,08600 / 7 200 | 1,7 ядра0,08 × 20 с | 5 ядер0,08 × 60 с |
| Последние 10 минут | 0,25×3 к двум часам | 5 ядересть 8, запас в 1,6 раза | 15 ядересть 8, очередь растёт |
Между средним и пиком разница в 125 раз. Система, посчитанная на среднее, встанет в последние десять минут сдачи
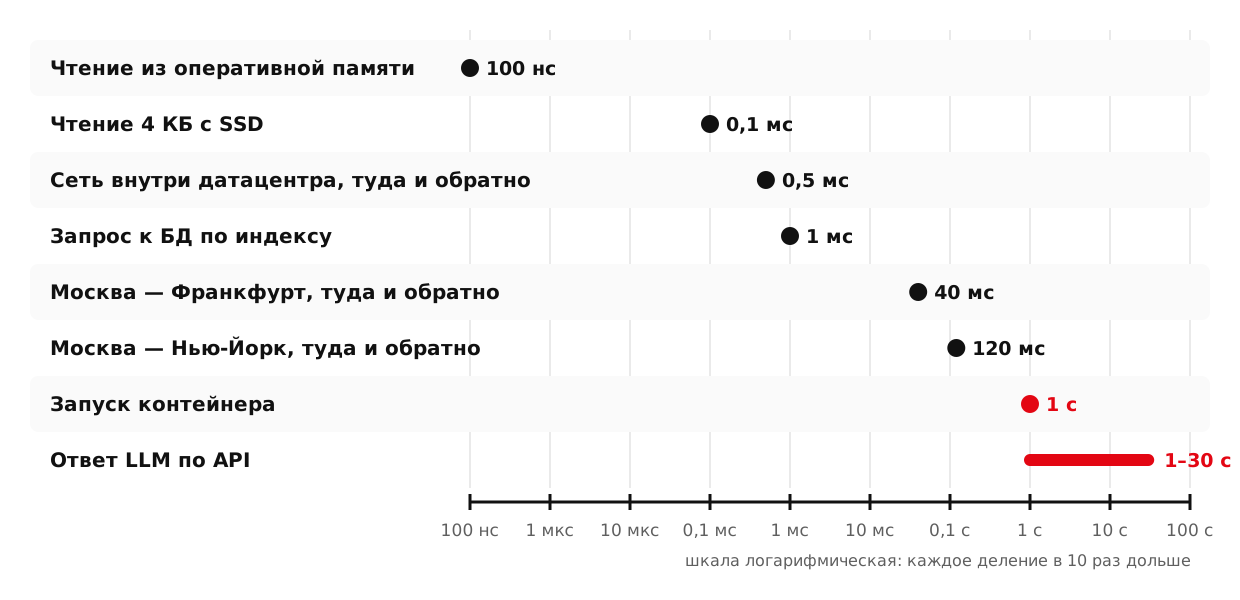
Порядки задержек
Числа от модели проверяем руками
- Модель уверенно выдаёт правдоподобную арифметику
- Типичный промах — единицы: КБ и МБ, секунды и минуты, в день и в секунду
- Просите формулу и подстановку, а не готовое число
- Пересчитайте сами или скриптом и сверьте порядок со здравым смыслом
Критический путь
Критический путь
Критический путь — это последовательность задач или процессов, которые требуют определенных ресурсов (вычислительных мощностей, памяти, сетевых ресурсов и т.д.), и любая задержка или недостаток этих ресурсов приводит к замедлению или остановке выполнения ключевых функций системы.
Оперативка
Диск
Процессор
Канал сети


Диск
Канал сети


Диск

Канал сети


Диск

Канал сети


Диск

Канал сети
Критический путь автопроверки
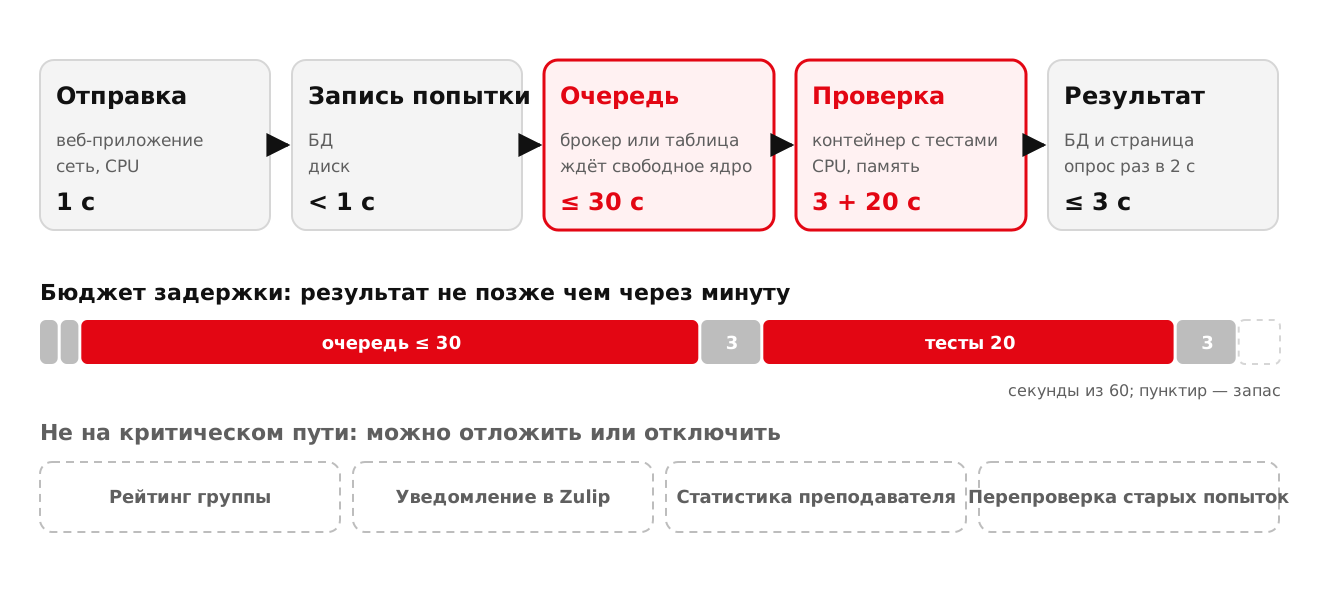
Как найти критический путь своей системы
- Взять главную user story — ради которой продукт существует
- Провести её стрелками по контейнерам своей C4
- Подписать на каждом шаге ресурс и время
- Разложить нефункциональное требование по шагам — это бюджет
- Отметить, что не на пути: это можно отключить
Как понять особенность системы?
Посмотреть на:
●Критический путь
●Свойства данных
●Допустимую деградация

Свойства данных автопроверки
Нельзя потерять
- Попытку и время отправки: по нему считается дедлайн
- Выставленные оценки
Можно пересчитать или подождать
- Результат проверки: тесты можно перезапустить
- Рейтинг группы: отстаёт на 10 минут
- Статистику преподавателя: раз в час
Особые
- Архивы решений тяжёлые: в объектное хранилище, не в БД
- ФИО и оценки — персональные данные: только своим
Ломаем систему и смотрим что получится
Как определить допустимую деградацию функций?


Что можно отключить
- Всё, что не на критическом пути: рекомендации, рейтинги, уведомления, аналитика
- Свежесть: обновлять раз в минуту вместо каждого запроса
- Точность: сначала быстрые проверки, полные потом
- Отложить: тяжёлое — в ночную очередь
- Ограничить: не больше N действий на пользователя за период
План деградации автопроверки
Частые ошибки в плане деградации
- Триггер «при высокой нагрузке» — без числа и метрики
- Отключают то, что стоит на критическом пути
- Нет пути назад: когда и как функции возвращаются
- Нет ответственного: кто нажимает кнопку в субботу в 23:50
- План есть, метрики для триггера нет
К защите RAT-PoC
- Три–пять главных рисков по группам, на матрице, с решением на каждый
- Самое рискованное допущение: «считаем… проверили так… получилось…»
- Прикидка нагрузки: откуда каждое число и какой ресурс упирается
- Критический путь на своей C4 с бюджетом задержки
- План деградации: триггер, что выключаем, кто, как возвращаем
Что дальше
- Практика: квест 5 «Прикидка на салфетке»
- Для своего проекта: риски, RAT, нагрузка, критический путь, деградация
- Опрос после пары
← → листать · F на весь экран · P режим докладчика · Esc выйти
Все слайды
О чём лекция
Через неделю защита RAT-PoC. Сегодня разбираем, что может сломать проект, какое допущение проверить первым, сколько ресурсов нужно системе и что она делает, когда их не хватает. Весь день идём на одном примере: автопроверке домашних заданий с дедлайном в субботу в 23:59.
- Риски. Чем риск отличается от задачи и от проблемы, форма «если — то». Три группы из рубрики: технические, архитектурные, бизнес. Где искать риски, матрица «вероятность × ущерб» и четыре способа обращаться с риском.
- Самое рискованное допущение. Что такое RAT, как сформулировать допущение и критерий успеха до проверки. Чем PoC отличается от прототипа и MVP.
- Прикидка нагрузки. Откуда брать аудиторию и ритм, почему систему считают на пик, а не на среднее. Закон Литтла: сколько запросов обрабатывается одновременно. Память, диск, сеть и порядки задержек. Почему числа от модели надо пересчитывать.
- Критический путь. Цепочка главного сценария по контейнерам C4, ресурс на каждом шаге и бюджет задержки. Свойства данных: что нельзя потерять, а что можно пересчитать.
- План деградации. Что можно отключить или упростить, триггеры по метрикам, кто включает уровень и как система возвращается обратно.
Что сделать сегодня
- Выписать три–пять главных рисков проекта в форме «если — то», разложить по группам и поставить на матрицу.
- Сформулировать самое рискованное допущение: «считаем… проверим так… подтвердилось, если…».
- Прикинуть пиковую нагрузку главного сценария и найти ресурс, который упрётся первым.
- Провести критический путь по своей C4 и составить план деградации: триггер, что выключаем, кто, как возвращаем.